장시간 비동기 작업, Kafka 대신 RDB 기반 Task Queue로
출처: 우아한형제들 기술블로그 — 장시간 비동기 작업, Kafka 대신 RDB 기반 Task Queue로 해결하기
엑셀 변환 서비스에서 Kafka를 제거하고 RDB 기반 Task Queue로 전환한 사례다. 관리 포인트를 줄이면서 운영 안정성은 오히려 높인 과정을 다룬다. 원문을 읽고 정리한 내용과 내 생각을 함께 적는다.
문제 상황
동일한 엑셀 파일이 사용자에게 중복 전송되는 문제가 보고됐다. 원인은 하나의 메시지가 여러 번 처리되는 것이었다.
엑셀 생성 과정에는 외부 API 호출이 포함되는데, 이 호출이 길어지면서 컨슈머의 처리 시간이 max.poll.interval.ms(기본 5분)를 초과했다. Kafka는 해당 컨슈머가 더 이상 응답하지 않는다고 판단해 컨슈머 그룹 리밸런싱을 수행하고, 파티션이 재할당되면서 아직 처리 중이던 메시지가 다른 컨슈머에게 다시 전달된다. 그 결과 같은 요청에 대해 엑셀이 중복 생성된다.
이것은 구현 결함이 아니다. Kafka는 문서화된 동작을 그대로 수행했다. 어긋난 쪽은 작업의 특성과 메시지 큐의 전제다. 메시지 큐는 짧은 시간 안에 끝나는 처리를 기준으로 컨슈머의 생존을 판단하는데, 이 작업의 처리 시간은 수십 분에서 수 시간에 이른다.
Kafka가 필요한 작업이었나
도입 시점의 기대는 두 가지였다. 트래픽 변동에 유연하게 대응하고, 필요하면 컨슈머 그룹을 늘려 수평 확장한다. 그러나 실제 운영 양상은 달랐다.
- 트래픽이 급증하는 구간이 관측되지 않았다.
- 컨슈머 그룹을 추가로 늘릴 필요가 없었다.
- 반면 장시간 작업으로
max.poll.interval.ms를 초과하는 사례는 계속 늘었다.
타임아웃 값을 늘리는 방법을 생각할 수 있으나, 이 값은 실제로 중단된 컨슈머를 감지하는 기준이기도 하다. 값을 키우면 장애 감지 시점이 그만큼 늦어진다. 정상 작업에 대한 오판과 장애 감지 지연을 맞바꾸는 선택이며, 어느 쪽으로 조정해도 근본적인 해결은 되지 않는다.
기대했던 이점은 활용하지 못한 채 제약만 남았다. 이 작업에 Kafka는 필요하지 않았다.
대체 구조의 요구사항
Kafka를 걷어내더라도 충족해야 할 요구사항은 다섯 가지였다.
- 처리 시간 제한 없음
- 작업 유실 방지
- 자동 재시도
- 병렬 처리
- 중복 방지
이 요구사항은 RDB 테이블 하나와 폴링 워커의 조합으로 충족할 수 있다.
전체 구조
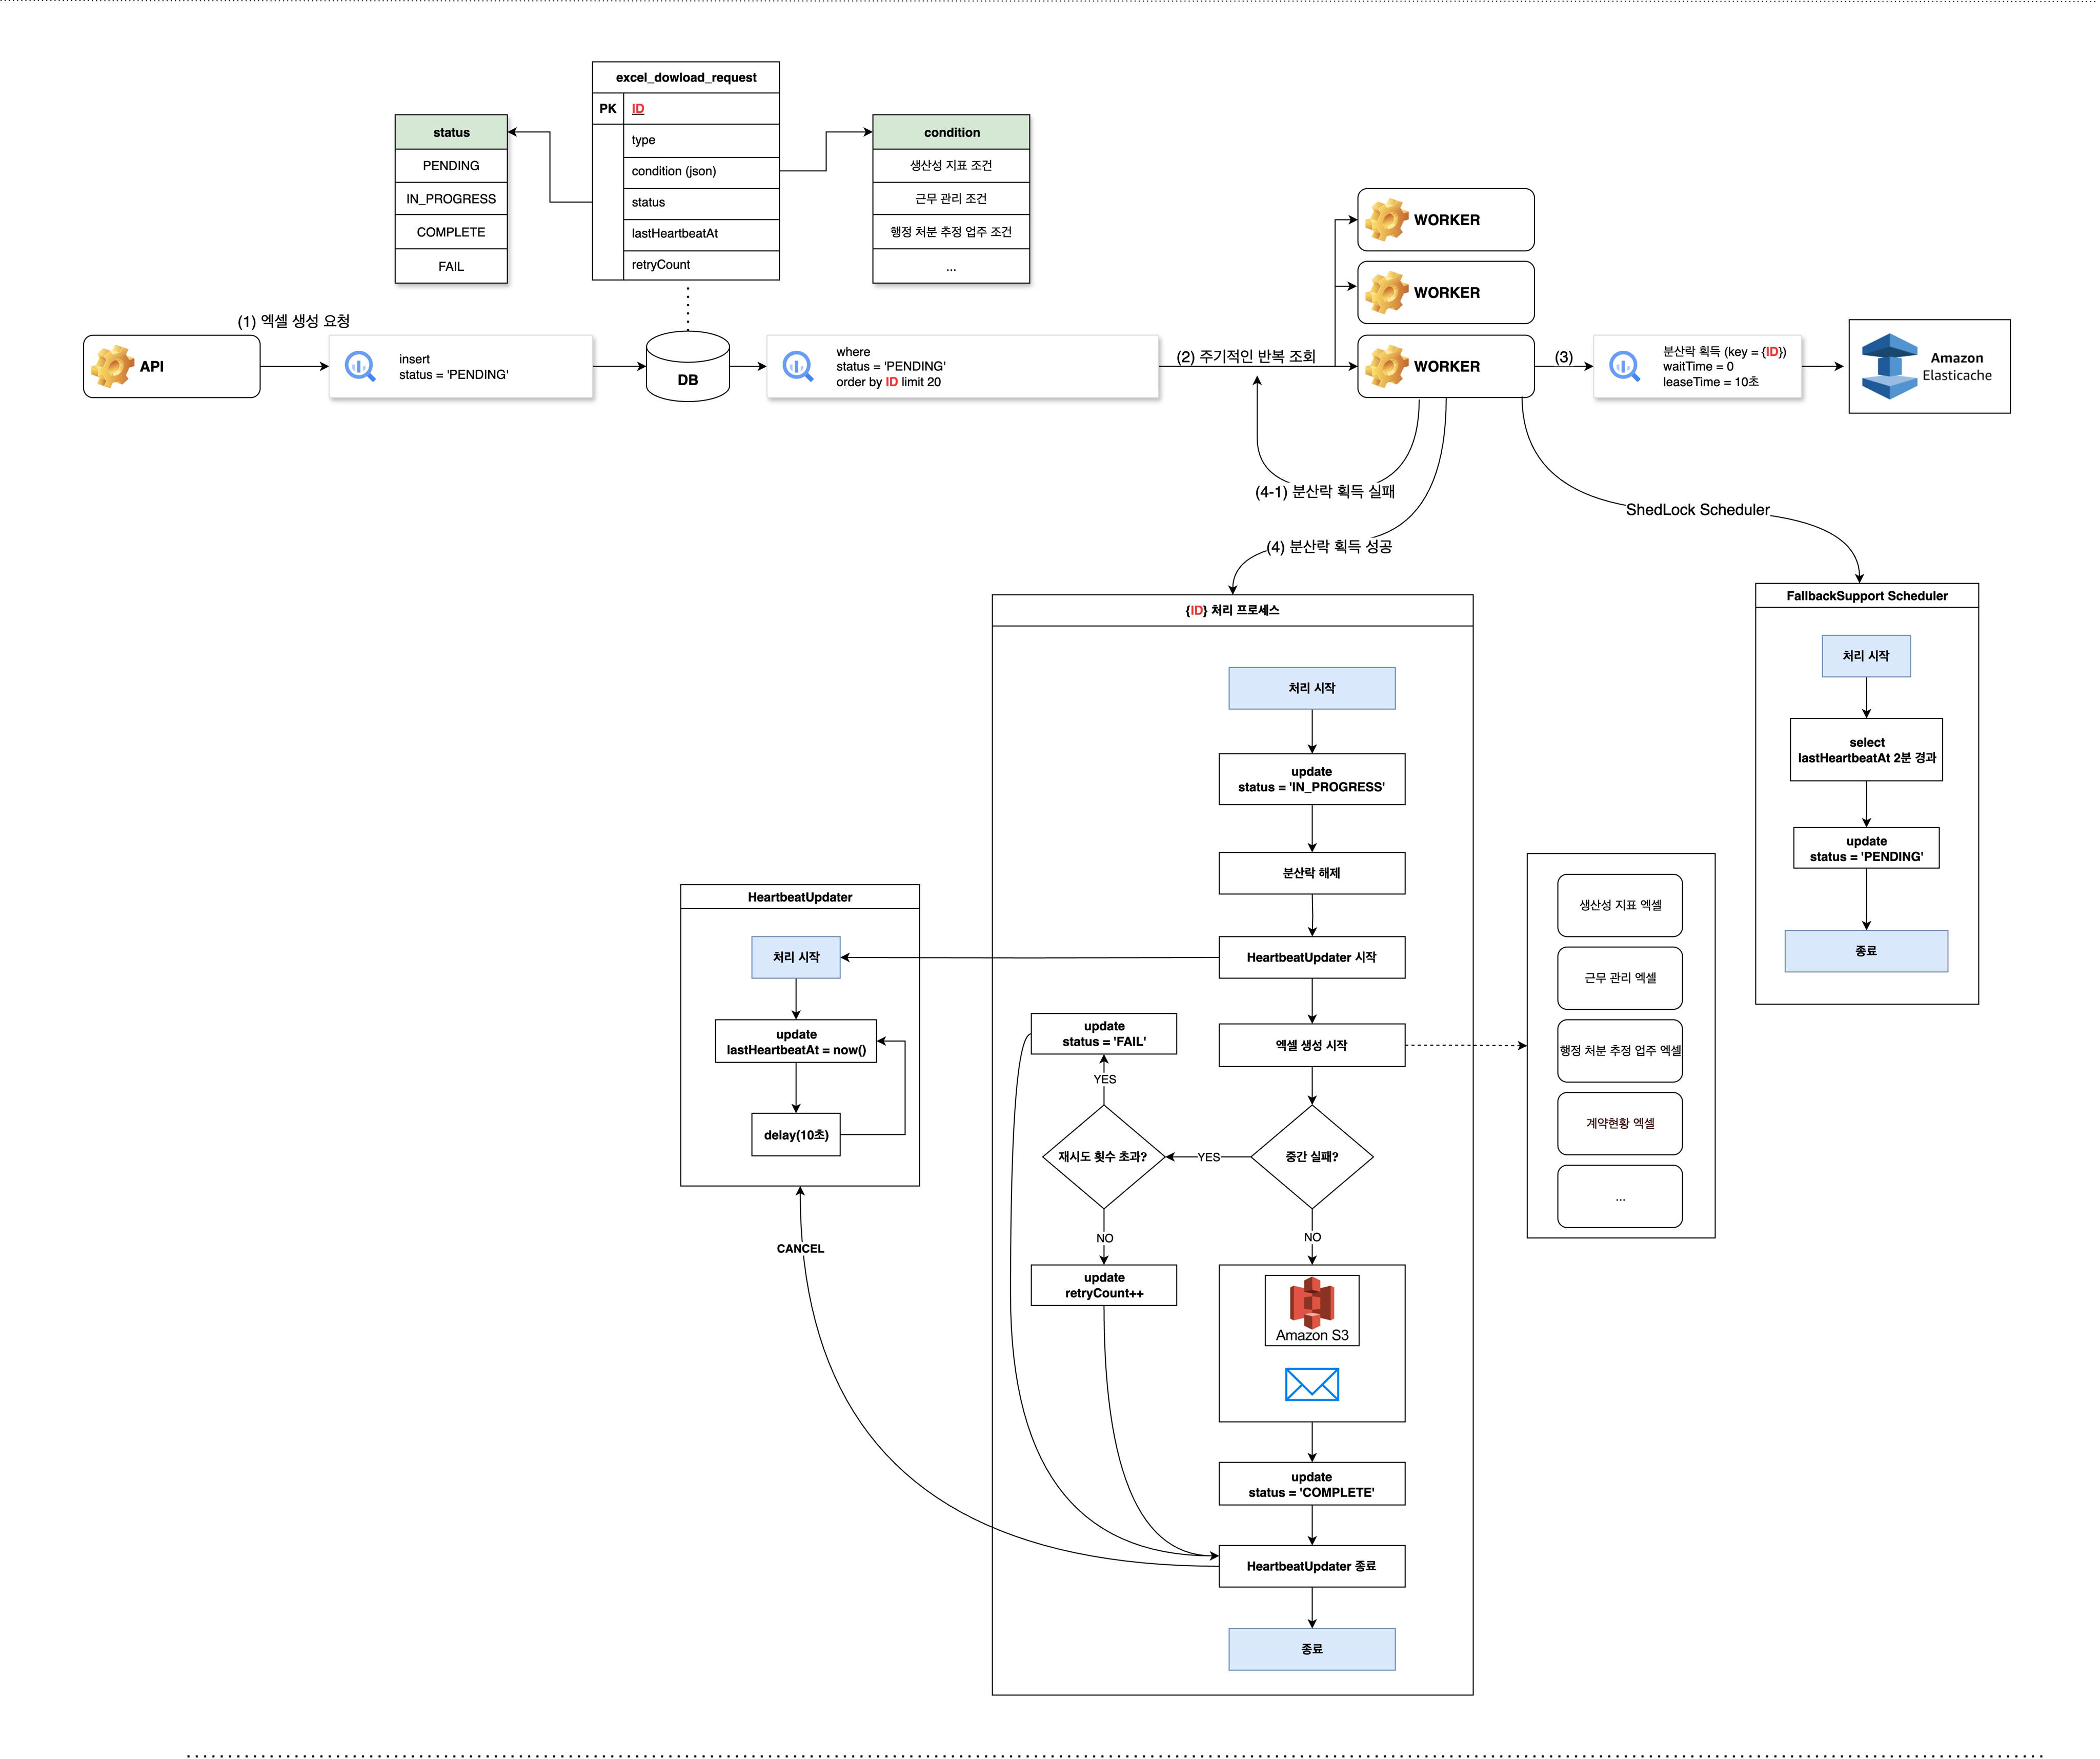
excel_download_request 테이블이 큐 역할을 한다. 작업 상태(PENDING → IN_PROGRESS → COMPLETE/FAIL), 마지막 heartbeat 시각, 재시도 횟수를 컬럼으로 관리하는 단순한 구조다.
처리 로직
1. 작업 선점
워커는 3초 주기로 PENDING 상태의 작업을 조회하고, Redis 분산락으로 워커 간 중복 선점을 차단한다.
-- PENDING 작업 조회
SELECT * FROM excel_download_request
WHERE status = 'PENDING'
ORDER BY id ASC
LIMIT 20;@Scheduled(fixedDelay = 3000) // 3초마다 실행
fun processExcelTasks() {
runBlocking(Dispatchers.IO) {
// 1. 대기 중인 작업 조회
val candidateTasks = taskQueryService.findByStatus(status = "PENDING", limit = 20)
// 2. Redis 분산 락으로 작업 선점 (최대 2개만)
val lockedTasks = candidateTasks
.asSequence()
.filter { task ->
redisClient.tryLock("TASK:${task.id}", leaseTime = 10_000)
}
.take(2) // 2개 선점
.toList()
// 3. 선점한 작업들을 병렬로 처리
lockedTasks.map { task ->
async { executeTask(task) }
}.awaitAll()
}
}조회는 20건이지만 실제 선점은 2건으로 제한한다. 락 획득에 실패한 작업은 다른 워커가 이미 선점한 것이므로 건너뛴다.
2. Heartbeat와 엑셀 생성
선점 직후 상태를 IN_PROGRESS로 변경하고 Redis 락을 해제한다. 락의 역할은 선점 시점의 경합 제어에 한정하고, 작업이 진행 중이라는 사실은 DB의 상태 값과 heartbeat가 표현한다. 처리에 한두 시간이 걸리는 작업이 그동안 락을 점유하는 것은 락의 목적에 맞지 않는다.
이후 워커는 일정 주기로 DB의 heartbeat 컬럼을 갱신해 작업이 진행 중임을 기록한다.
private suspend fun executeTask(task: ExcelTask) = coroutineScope {
    // 1. 상태 변경 후 락 해제
    taskCommandService.updateStatus(
        id = task.id,
        status = "IN_PROGRESS",
    )
    redis.unlock("TASK:${task.id}")

    // 2. Heartbeat update 코루틴 시작
    val heartbeatUpdateJob = launch {
        while (this.isActive) {
            taskService.updateHeartbeat(task.id, LocalDateTime.now())
            delay(60_000)  // 1분마다
        }
    }

    try {
        // 3. 실제 엑셀 생성 작업 수행 (최대 1시간~2시간 소요)
        generateExcel(task)
        taskCommandService.updateStatus(task.id, "DONE")
    } catch (e: Exception) {
        // 4. 실패 시 재시도 처리
        handleRetry(task)
    } finally {
        heartbeatUpdateJob.cancelAndJoin()
    }
}
Kafka의 타임아웃이 정해진 시간 안에 완료되지 않은 컨슈머를 중단된 것으로 간주하는 방식이라면, heartbeat는 워커가 생존 신호를 보내는 동안 처리를 계속 허용하는 방식이다. 처리 시간의 상한이 사라지는 지점이 여기다.
3. 재시도 처리
예외가 발생해도 즉시 실패로 확정하지 않는다. 재시도 횟수를 증가시키고 상태를 PENDING으로 되돌려 큐에 다시 편입시킨다.
fun handleRetry(task: ExcelTask) {
    val retryCount = task.retryCount + 1
    if (retryCount < 3) {
        // 3회 미만 - PENDING으로 되돌려 재시도
        taskService.updateRetryCount(task.id, retryCount)
        taskService.updateStatus(task.id, "PENDING")
    } else {
        // 3회 이상 - 최종 실패 처리
        taskService.updateStatus(task.id, "FAILED")
    }
}
재시도 횟수가 테이블 컬럼에 남기 때문에 어떤 작업이 몇 번 실패했는지 쿼리로 확인할 수 있다.
4. 장애 복구
워커 프로세스가 비정상 종료되거나 배포로 중단되면 heartbeat 갱신도 함께 멈춘다. 해당 작업은 IN_PROGRESS 상태로 남아 어떤 워커도 처리하지 않는 상태가 되므로, 별도 스케줄러가 이를 회수해 PENDING으로 되돌린다.
-- 2분 이상 Heartbeat 없는 작업 찾기
SELECT * FROM excel_download_request
WHERE status = 'IN_PROGRESS'
  AND last_heartbeat_at < NOW() - INTERVAL 2 MINUTE;
// 새로운 스케쥴러
@Scheduled(cron = "0 */2 * * * *") // 2분마다 실행
@SchedulerLock( // 1대의 워커에서만 수행되도록 Shedlock 사용
name = "FallbackSupportScheduler",
lockAtLeastFor = "PT1M",
lockAtMostFor = "PT2M",
)
fun fallbackSupportScheduler() {
// 2분 이상 heartbeat 없는 작업 조회
val stopedTasks = taskService.findFallbackTasks(
now = LocalDateTime.now()
)
stopedTasks.forEach { task ->
// PENDING으로 되돌려 다른 Worker가 처리하도록 함
taskService.updateStatus(task.id, "PENDING")
}
}복구 스케줄러가 여러 워커에서 동시에 실행되면 같은 작업을 중복 회수할 수 있으므로 ShedLock으로 단일 실행을 보장한다. 작업 선점에는 Redis 분산락을, 스케줄 실행에는 ShedLock을 사용하는 이중 구조다.
전환의 효과
시스템 복잡도 감소. 상태가 DB 한 곳에 집중되므로 추적이 단순하다. 특정 요청이 현재 어느 단계에 있는지 확인하는 데 SELECT 한 번이면 충분하다.
안정성 향상. 메시지 재발행이나 유실을 고려할 필요가 없고, heartbeat 기반 복구가 워커 장애를 흡수한다.
운영 효율성. 워커를 수평 확장해도 분산락이 중복 처리를 차단하며, 모니터링은 테이블 조회로 대체된다.
트레이드오프
DB 부하. 폴링 쿼리가 주기적으로 발생하지만 커버링 인덱스로 비용을 낮출 수 있고, 전체 요청량 자체가 크지 않다.
처리 시작 지연. 폴링 주기만큼 시작이 늦어진다. 다만 처리에 1~2시간이 걸리는 작업에서 3초의 지연은 유의미하지 않다.
두 비용 모두 이 워크로드에서는 수용할 만하다. 요청량이 훨씬 많은 도메인이었다면 결론이 달라졌을 것이다.
정리하며
외부 연동이 포함된 작업은 비동기 처리와 메시지 큐의 조합이 기본이라고 생각해왔다. 이 사례는 그 전제를 다시 보게 만들었다.
처리 시간이 길고 요청량이 많지 않은 워크로드에서는 메시지 큐가 제공하는 이점보다 메시지 큐가 요구하는 제약이 더 크게 작용한다. 실제로 전환 전후의 구조는 크게 다르지 않다. 요청을 적재하고, 워커가 가져가 처리하고, 실패하면 재시도한다는 흐름은 동일하다. 차이는 그 사이에 Kafka라는 계층을 두느냐 아니냐다.
기술 선택의 기준은 그 기술이 우수한지가 아니라 현재 워크로드가 그 기술의 전제를 만족하는지에 있다. 트래픽 급증 대응과 확장성은 Kafka의 분명한 강점이지만 이 서비스에는 해당하지 않는 강점이었고, 장시간 작업에 대한 제약만 그대로 비용으로 남았다.
적용해볼 것
현재 참여 중인 프로젝트에도 Kafka 파이프라인이 필요 이상으로 복잡하게 구성되어 있다. 각 파이프라인이 Kafka의 어떤 특성을 실제로 사용하고 있는지부터 점검하고, 근거가 확인되지 않는 구간은 더 단순한 구조로 대체해볼 계획이다.